导读:前几篇我们把 Zabbix 的主机和 MySQL 指标搬进了 Grafana 大屏。但大屏再漂亮,也得有人"盯着"才算数——值班同学不可能 7×24 盯着墙。这篇补上闭环的关键一块:Grafana Alerting 告警链路。CPU 飙了、磁盘满了、MySQL 延迟超阈值,Grafana 自动把告警卡片推到企微群,30 秒内 @ 到人。全程 5 步配置,附每一步的高清截图。
Zabbix 的 Trigger + 动作体系很成熟,但当你已经把展示层统一到 Grafana之后,告警也放进 Grafana 有三个实打实的好处: 当然,Zabbix 侧的告警可以继续保留作为"老保底",两者并存互不影响。 Zabbix 指标(API) 记住这条链路的四个关卡:规则(何时响)→ 标签(我是谁)→ 策略(发给谁)→ 渠道(怎么发)。下面逐步打通。 进入 Alerting → Alert rules → + New alert rule。核心是把"CPU 负载过高"翻译成三段式条件: 查询 A 表达式 B 表达式 C 三处细节决定告警好不好用: 评估间隔 Labels Annotations 踩坑提醒:新装的 Grafana 如果 Alerting 菜单里没有 unified alerting 相关页面,检查 先在企微群里建机器人:群设置 → 群机器人 → 添加机器人,复制拿到的 Webhook 地址(形如 然后进入 Alerting → Contact points → + Add contact point: Integration URL HTTP Method 关键认知(少走 2 小时弯路):企微群机器人只认它自己的报文格式( 这是 Alerting 里非常关键的一层。进入 Alerting → Notification policies,树状结构一目了然: Default policy 子策略 1 子策略 2 子策略 3 这样"值班"语义就出来了:critical 进值班群实时 @,warning 进静默群白天看,DBA 的数据库告警单独走自己的群,运维群里不再被 MySQL 告警刷屏。 压测把 web-prod-01 的 CPU 拉高,30 秒内告警进入 Firing。回到 Alerting → Alert list,触发中、待定、已恢复的状态和趋势尽收眼底: 与此同时,企微群里收到两张 markdown 卡片——标题红色、主机、级别、当前值、持续时长、直达 Grafana 的链接一应俱全: 指标回落并持续一段时间后,同一条消息会自动补充"Resolved 已恢复",告警有始有终,值班同学不用手工关单。 Pending 缓冲,拒绝抖动 按主机合并轰炸 消息里带数值 Keep Last State Silence 静默窗口 告警即代码 到这里,Zabbix × Grafana 系列的监控闭环就完整了:采集(Zabbix)→ 展示(Grafana 大屏)→ 告警(Alerting)→ 送达(企微群)。监控的价值不在图好看,而在"出事有人知道、多快知道、知道得够不够多"。一条带数值、带链接、自动恢复的企微卡片,往往比任何大屏都更能体现监控体系的成熟度。为什么不用 Zabbix 自带告警?
先看全链路:一条告警是怎么流到企微群的
↓ Grafana 定时查询(每 30s 评估)
↓ Alert Rule:last() of CPU load IS ABOVE 阈值
↓ 打上 Label(severity=critical)
↓ Notification Policy 按 Label 匹配路由
↓ Contact Point:Webhook → 企微群机器人
↓ ✔ 运维告警群收到告警卡片第一步:创建告警规则(Alert rules)
$host → Item: CPU load (1m);last(),取最近一个采样点;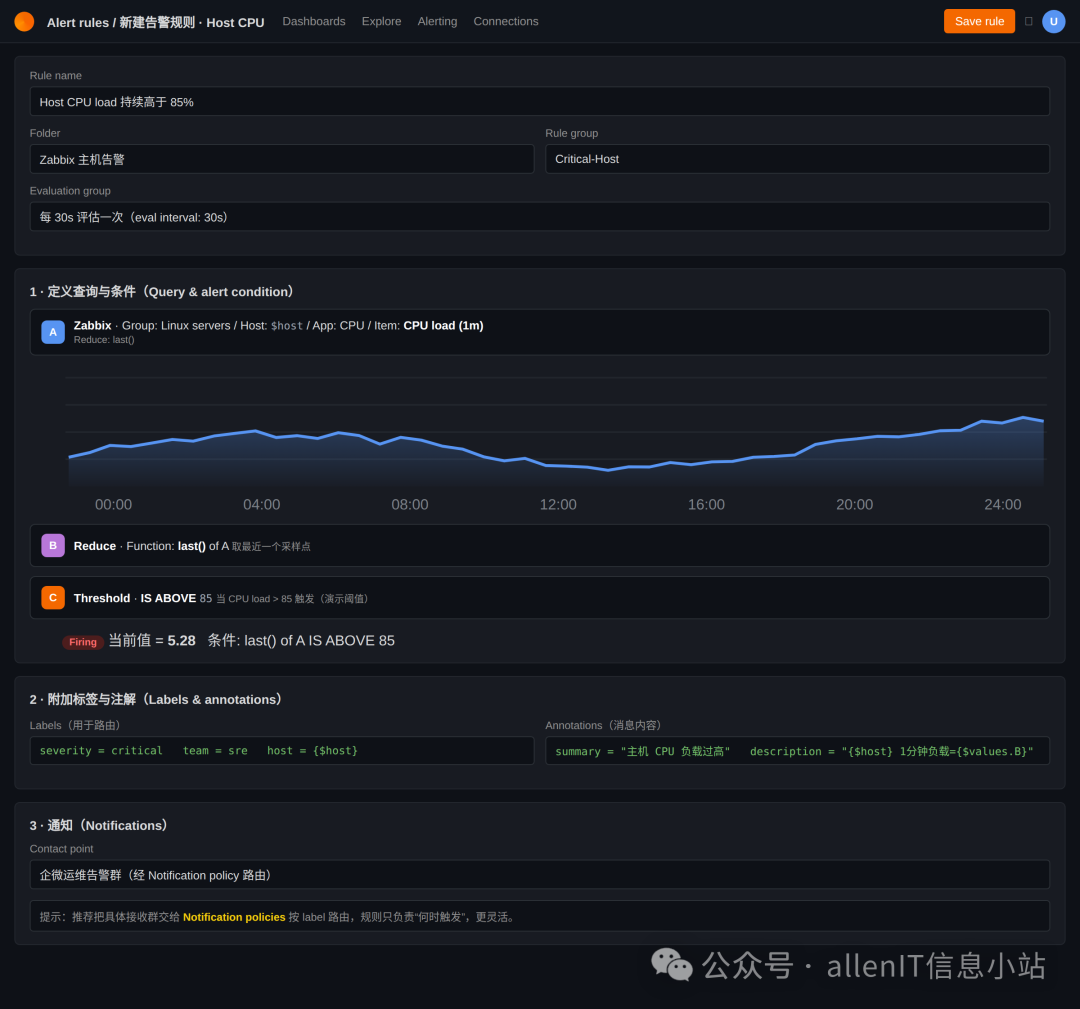
30s,越短发现越快,但别低于采集周期;severity=critical、team=sre——这是后面路由的"钥匙";{{$host}} 1分钟负载={{$values.B}} 把具体数值写进消息,收到告警不用再翻系统。ngalert 是否启用(Grafana 9+ 默认开启,7.0 升级上来的老实例需要手动开)。另外规则保存后默认暂停评估的实例极少见,但首次建议点 Preview 看一眼条件预览再保存。第二步:配置企微群通知渠道(Contact points)
https://qyapi.weixin.qq.com/cgi-bin/webhook/send?key=xxx)。Webhook;POST,Content type 选 application/json;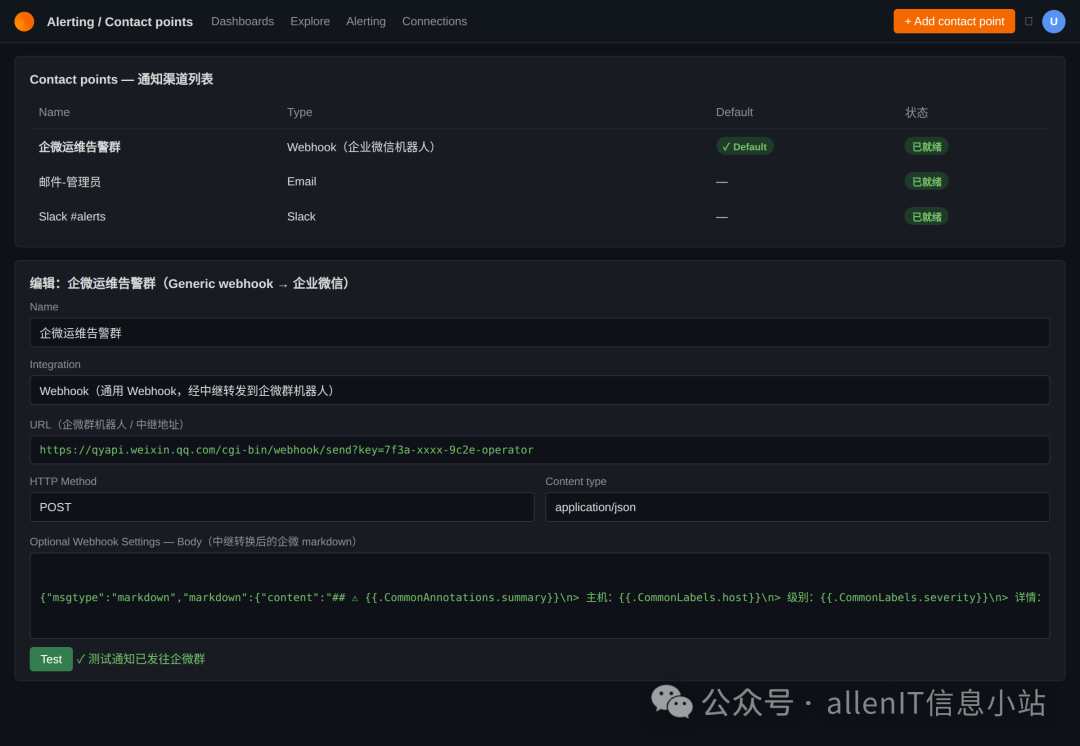
msgtype: markdown),而 Grafana 的通用 Webhook 发的是自己的 payload,直连会 400。三个解法:
① 写一个 10 行的轻量中继(Nginx + Lua / 一个 Flask 脚本),把 Grafana payload 转成企微格式——常用;
② 用 Grafana OnCall,自带企微集成,还能做认领、升级;
③ 保留 Zabbix 侧企微告警媒介,Grafana 只做大屏——不推荐,链路分裂。第三步:通知策略(Notification policies)— 谁的告警进谁的群
severity = critical → 企微运维告警群,并设置 Group by: host(同一主机的多条告警合并,5 分钟内不重复轰炸);team = dba → 企微 DBA 群;severity = warning → 监控静默群(只在工作时间 @)。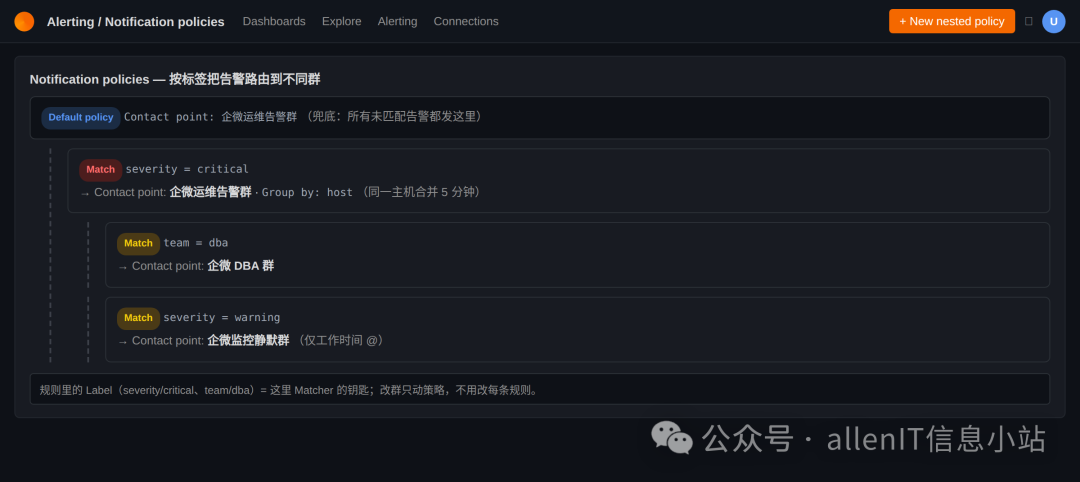
实战效果:告警长什么样
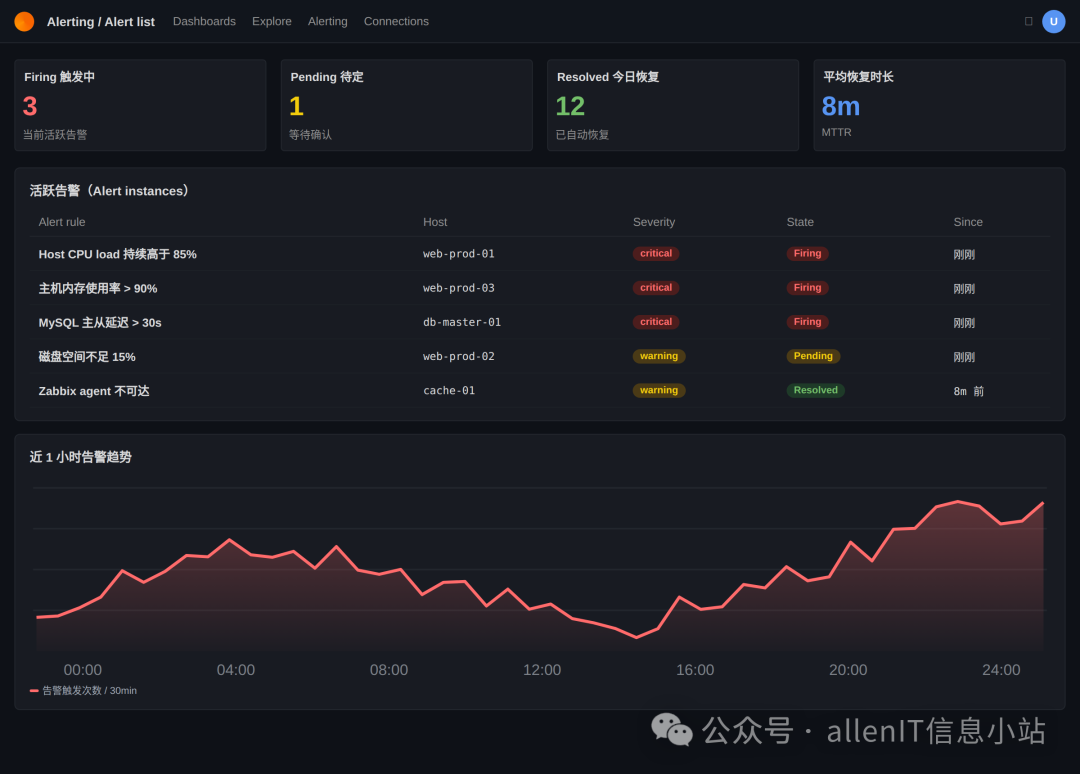
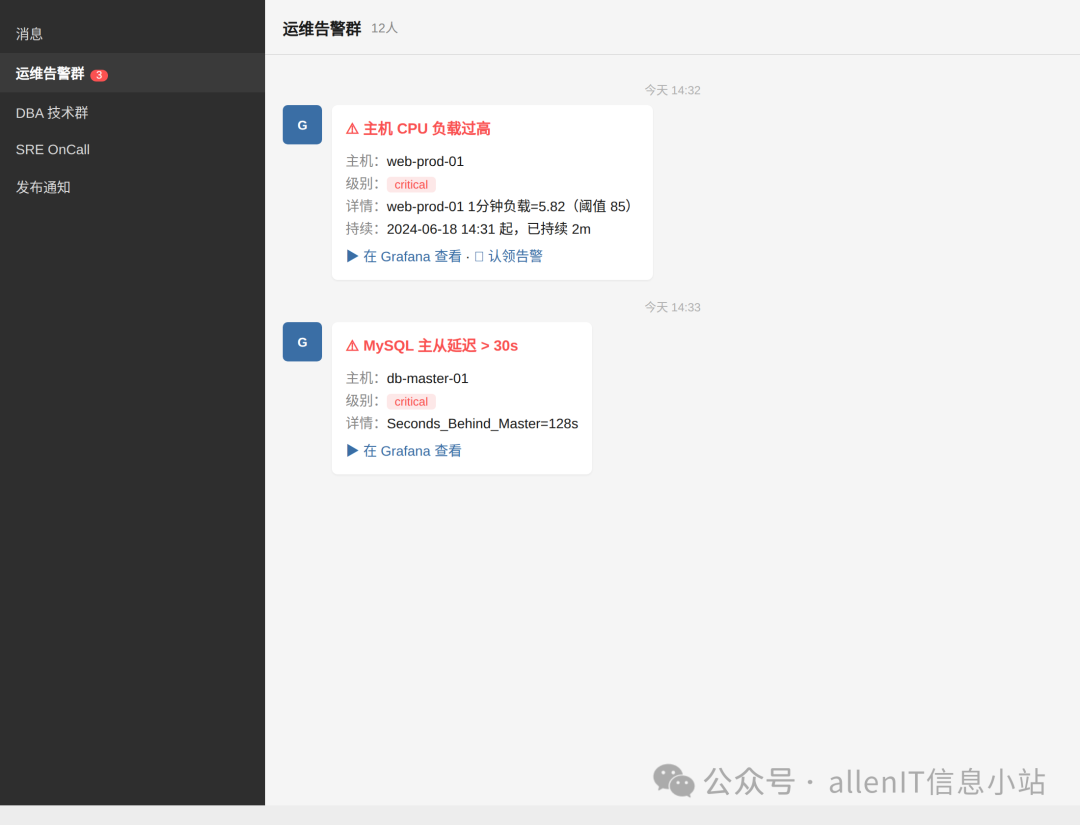
进阶技巧:让告警更"懂事"
for 2m(Alert Evaluation Behavior → Set alert state if error / pending)让条件持续 2 分钟才 Firing,瞬时毛刺不再半夜叫人;host,同一主机批量告警合并成一条 markdown,加上 Mute timings 设定免打扰时段;{{$values.B}}(人类可读)与 {{$value}}(原始值),配合 {{$labels.host}},卡片信息量拉满;host=xxx 静默 2 小时,发版不告警;常见问题(FAQ)
for 持续条件写在最后
 支付宝微信扫一扫,打赏作者吧~
本文链接:https://kinber.cn/post/6825.html 转载需授权!
推荐本站淘宝优惠价购买喜欢的宝贝:
 您阅读本篇文章共花了: