在前面
前面四篇连载,我们彻底打通了 SQL Server 性能调优的核心闭环: 从统计信息校准、执行计划解读、参数嗅探解决,再到根治 SQL 劣质写法,基本解决了绝大多数显性慢查询问题。
但很多朋友会发现一个诡异的问题: 同样的 SQL、同样的索引、同样的写法,刚优化完飞快,跑一段时间性能又慢慢变差。 没有新增业务、没有数据暴涨、没有语句变更,性能却持续退化。
这就是绝大多数运维忽略的数据库隐形慢性病:索引碎片堆积 + 无用索引冗余堆积。
索引从不是建好就永久生效,它是需要定期养护的基础设施。 今天这篇收尾运维篇,全部是生产可落地的实操,教你如何科学维护索引、清理垃圾索引,守住数据库长期稳定。
如果你是新读者,本文可直接作为索引运维独立实操指南,无需阅读前文即可上手。
一、先搞懂:索引碎片到底是什么?
我们常用的非聚集索引、聚集索引,本质都是 B + 树结构。
ERP 系统高频的新增、修改、删除、归档操作,会持续改动索引页数据: 页面数据被删除、数据移位、页面拆分、空间空置……
久而久之就会出现:逻辑顺序混乱、物理磁盘顺序错乱、大量空页闲置,这就是索引碎片。
直白人话:
无碎片索引:数据连续规整,查询一次读取就能拿到连续数据,IO极低;
高碎片索引:数据东一块西一块,查询需要读取更多磁盘页,逻辑读、物理读翻倍,查询持续变慢。
二、碎片不清理,会引发哪些生产故障?
很多人觉得碎片不影响使用,只是轻微损耗,这是严重误区。 在 ERP 千万级大表(MRTLOT、RESVT 等)上,高碎片会引发连锁问题:
查询性能持续退化:索引有序性变差,Seek 效率下降,极易从精准查找变为扫描;
写入压力暴涨:新增、修改单据需要频繁维护碎片化索引,CPU、IO 持续偏高;
统计信息更新失真:碎片过高会干扰数据分布统计,间接诱发参数嗅探、执行计划错乱;
数据库空间浪费:大量索引空页堆积,占用磁盘空间却无任何业务价值。
核心真相:小表碎片无伤大雅,大表碎片是性能雪崩的源头。
三、实战脚本:一键查询全表索引碎片率(SQL2014兼容)
直接使用以下脚本,排查目标表所有索引碎片情况,精准定位需要维护的索引,并生成维护 SQL 脚本。
SELECT OBJECT_NAME(ips.object_id) AS TableName, i.name AS IndexName, i.type_desc, ips.avg_fragmentation_in_percent, ips.page_count, CAST(ips.page_count * 8.0 / 1024 AS DECIMAL(18,2)) AS SizeMB, CASE WHEN i.type_desc='HEAP' THEN 'ALTER TABLE [dbo].['+OBJECT_NAME(ips.object_id)+'] REBUILD;'WHEN ips.avg_fragmentation_in_percent > 30 THEN 'ALTER INDEX [' + i.name + '] ON [' + OBJECT_NAME(ips.object_id) + '] REBUILD WITH (SORT_IN_TEMPDB=ON,MAXDOP=4,FILLFACTOR=80);' WHEN ips.avg_fragmentation_in_percent BETWEEN 10 AND 30 THEN 'ALTER INDEX [' + i.name + '] ON [' + OBJECT_NAME(ips.object_id) + '] REORGANIZE;' ELSE '-- OK' END AS ActionSQLFROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'LIMITED') ipsJOIN sys.indexes i ON ips.object_id=i.object_id AND ips.index_id=i.index_idWHERE ips.avg_fragmentation_in_percent > 10 AND ips.page_count > 1000 AND OBJECT_NAME(ips.object_id) NOT LIKE 'sys%'ORDER BY ips.avg_fragmentation_in_percent DESC;
四、两种索引维护方式,90%人都用错了
索引维护只有两种方式:重组、重建。很多人不管碎片高低,统一重建,白白增加业务压力。
1、索引重组 REORGANIZE(轻量日常维护)
适用场景:碎片 5%-30%、日常巡检维护、业务不中断
特点:在线整理、渐进式优化、几乎无锁、不影响读写业务、压力极小。
--碎片 5%~30% → REORGANIZE(重组,不锁表)--单索引重组 实例 ALTER INDEX I_ALLSTOCK_CO_CODE_TDATE ON ALLSTOCK REORGANIZE;
2、索引重建 REBUILD(深度根治重度碎片)
适用场景:碎片 > 30%、长期未维护、数据大批量归档 / 删除后
特点:彻底删除旧索引、重新生成全新规整索引,碎片直接清零,性能最优。
⚠️ 关键兼容提醒:SQL2014标准版不支持在线重建,高峰期会锁表,务必选择凌晨低峰窗口执行!
--高碎片30% 索引重建ALTER INDEX PK_ALLSTOCK ON ALLSTOCK REBUILD WITH(SORT_IN_TEMPDB=ON,MAXDOP=4,FILLFACTOR=80);
大表补充建议:对于 >50GB 的超大表,即使碎片 >30%,也建议优先使用 REORGANIZE 分批次整理,或使用分区级重建,避免单次维护窗口不够导致任务超时。
运维铁律:小碎片重组、大碎片重建,绝不盲目全量重建。
五、比碎片更坑的隐患:无用冗余索引
很多数据库越优化越卡,不是索引太少,是索引太多、太乱、大量冗余。
新手只知道建索引,从不删索引,长期下来一张大表十几条索引:
相似索引、重复索引、长期零访问索引、被覆盖废弃索引堆积。
冗余索引的致命危害
查询几乎无收益,极少被优化器选用; 写入开销翻倍:新增、修改、删除单据,需要同步维护所有冗余索引,严重拖慢事务速度; 加剧碎片产生、占用磁盘空间、拖累整体性能。
实战脚本:查询表从未使用的索引
-- sql --单表未使用索引查询SELECT OBJECT_NAME(s.object_id) AS 表名, i.name AS 索引名FROM sys.dm_db_index_usage_stats sRIGHT JOIN sys.indexes i ON s.object_id = i.object_id AND s.index_id = i.index_idWHERE OBJECT_NAME(s.object_id) = '表名' AND s.user_seeks IS NULL;
上线超过1个月,且期间数据库实例未发生过重启,零Seek、零扫描的索引,可判定为僵尸索引。
重要修正说明:
- sys.dm_db_index_usage_stats 会在 SQL Server 实例重启或数据库分离/附加后清零
- REBUILD 不会清零,索引重建后使用统计会被保留
- 因此判断僵尸索引时,务必确认数据库已稳定运行超过一个月且未重启,切勿在刚重启的库里直接删索引!
六、高危误区:相似重复索引,绝大多数人都在踩
这是最隐蔽的索引冗余:前缀相同的复合索引
举例:
索引A:APPROVED,TDATE
索引B:APPROVED,TDATE,JOBNO
结论:索引A完全冗余,可以直接删除。
符合最左前缀原则,长索引可以完全替代短索引,保留长索引、删除短索引,零性能损耗,大幅减负写入压力。
删除前必须确认的安全检查清单
1、是否 UNIQUE 约束 | 短索引如果是唯一约束,长索引不是唯一,不能删除
2、是否聚集索引 | 聚集索引决定了数据物理存储顺序,不能随便删除
3、是否被外键引用 | 外键引用的索引删除可能报错,需先处理外键
4、是否包含特殊 INCLUDE 列 | 长索引不一定覆盖了短索引的 INCLUDE 列,需逐一比对
建议:删除前务必在测试环境验证,确认业务查询的执行计划没有退化,再在生产环境操作。
七、实战运维复盘
本次主要优化百万级以上大表,共排查出以下典型问题:
1、索引碎片高达40%+,长期未维护,查询IO持续偏高;
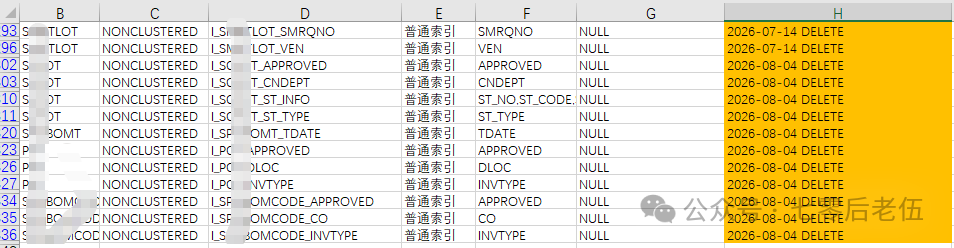
2、存在99条零访问僵尸索引,长期占用资源、无任何查询收益;
3、存在前缀重复索引,写入冗余开销严重。
落地优化动作:
1、REORGANIZE重组索引1500个左右;
2、REBUILD重建索引1000个左右;
3、删除99条长期无用僵尸索引;
4、清理重复前缀冗余索引,保留最优覆盖索引。
优化结果:最好的就是用户都反馈:速度快了。原来的产品资料保存需要25秒,现在只需要3秒。
单据保存、批量修改速度明显提升,后台报表IO进一步下降,数据库稳态性能大幅优化。
八、可直接落地的索引运维规范(建议收藏)
结合ERP生产经验,整理一套标准化运维节奏,彻底告别索引乱象:
1、每日巡检:监控大表索引碎片波动、异常IO波动;
2、每周轻维护:对5%-30%碎片索引统一REORGANIZE重组;
3、每月深维护:低峰窗口对高碎片索引REBUILD重建;
4、每月清理:排查零使用索引、重复索引,及时清理减负;
5、大批量数据操作后:归档、批量删除完成后,必须维护索引+更新统计信息。
6、每次维护前后:记录索引大小、碎片率、主要查询执行时间,验证正向提升,防止填充因子调整导致统计信息异常
目前自动化方案
我已创建两个存储过程:
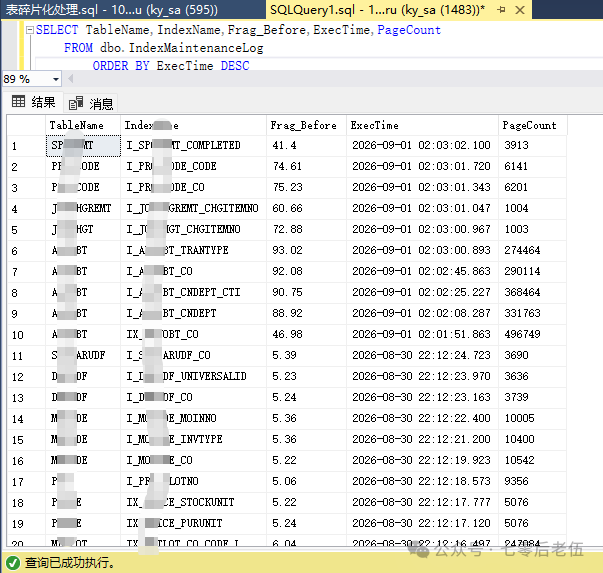
REORGANIZE 重组 SP:定时任务每周日晚上 22 点执行 REBUILD 重建 SP:定时任务每月 1 号凌晨 2 点执行
每次执行均记录:操作表名、索引名、操作前碎片率、执行时间、页。
写在最后
很多人调优只关注「怎么建索引」,却忽略了「怎么养索引、怎么清索引」。 优秀的索引结构,离不开长期科学的运维;干净的索引环境,才是数据库稳定的基石。
碎片堆积、冗余索引泛滥,看似无伤大雅,实则会慢慢蚕食数据库性能,最终引发批量卡顿、业务超时。
到这里,索引全套调优体系(统计信息、执行计划、参数嗅探、SQL 写法、索引运维)已经全部讲完。
本文所有脚本已在SQL Server 2014+生产环境验证通过。
 支付宝微信扫一扫,打赏作者吧~
本文链接:https://kinber.cn/post/6787.html 转载需授权!
推荐本站淘宝优惠价购买喜欢的宝贝:
 您阅读本篇文章共花了:

